고정 헤더 영역
상세 컨텐츠
본문
1. conda 가상환경 만들기
- (1) conda에서 가상환경 만들기 (예시)
・ 가상환경 이름 : torch_gpu
・ 파이썬 버전 : 3.12.2
# python 버전 찾기
conda search python

# 가상환경 만들기
conda create -n torch_gpu python=3.12.2
- (2) PyTorch 공식 홈페이지에서 Run this Command 확인하기

・ Run this Command:에 있는 명령어를 복사한다.
2. torch 설치하기
- (1) 가상환경 접속
# 가상환경 접속
source activate torch_gpu
- (2) PyTorch 설치
pip3 install torch torchvision
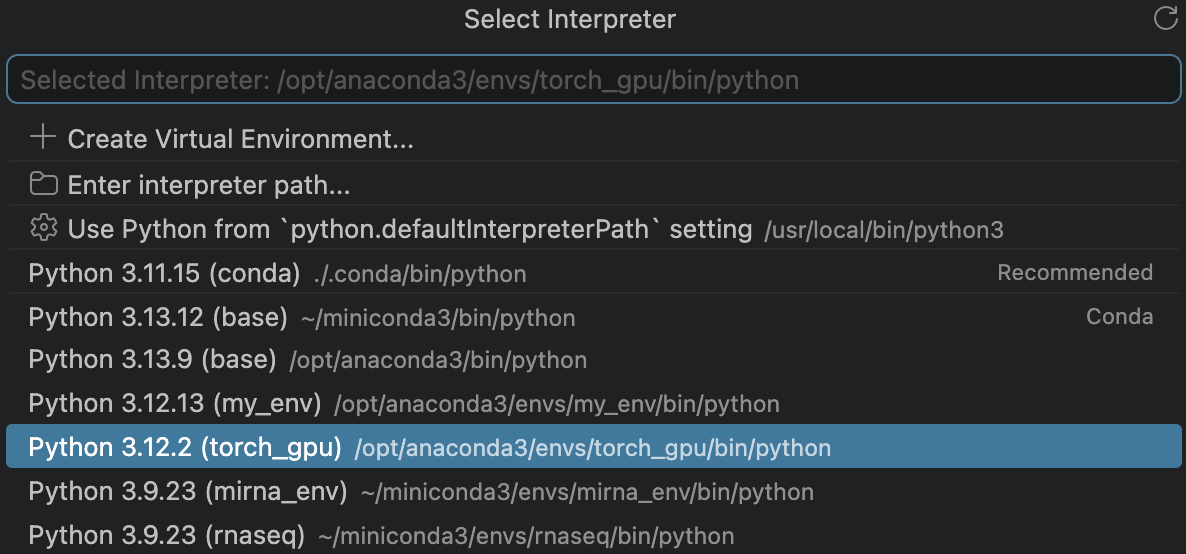
- (3) VS Code에 가상환경 연결
・ 인터프리터 선택 : [command] + [shift] + p를 눌러 명령어 팔레트를 연다.
・ Python 선택 : 팔레트 창에 Python: Select Interpreter를 입력하고 선택한다.
・ 가상환경 지정 : 목록에서 방금 생성한 Anaconda 가상환경을 선택한다.
- (4) 가상환경 적용 확인
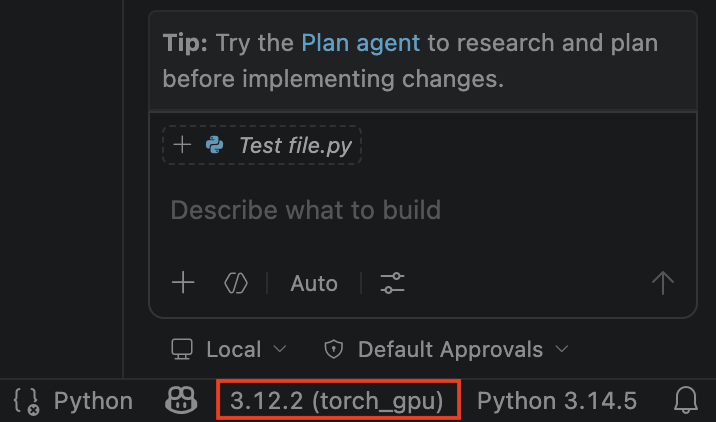
・ VS Code 우측 하단 상태바에서 선택된 파이썬 버전을 확인한다.
・ 가상환경 이름이 표시된다면 정상적으로 연결이 완료된 것이다.
3. GPU 사용 여부 확인
- (1) VS Code에 코드 입력
・ VS Code에 다음 코드를 입력하여 사용 가능한지 확인한다.
・ M1, M2, M3 등 Apple Silicon 칩을 사용하는 경우 Cuda가 아닌 MPS로 GPU를 가속화한다.
import torch

def check_mps_availability():

    # MPS 사용 가능 여부를 확인합니다.
    if torch.backends.mps.is_available():
        print("이 장치에서 MPS(GPU 가속)를 사용할 수 있습니다.")
    else:
        print("MPS를 사용할 수 없습니다. CPU를 사용합니다.")

#  GPU 사용 가능 여부를 확인합니다.
check_mps_availability()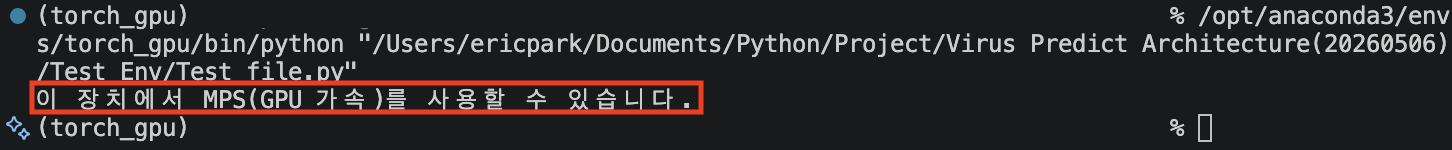
- (2) Cuda & MPS
・ CUDA
a. NVIDIA가 개발한 GPU 병렬 컴퓨팅 플랫폼/API. NVIDIA GPU에서만 작동한다.
b. 거의 모든 딥러닝 프레임워크(PyTorch, TensorFlow 등)에서 1순위로 지원한다.
c. 방대한 커뮤니티와 최적화된 라이브러리(cuDNN 등)를 갖추고 있다.
d. CPU와 GPU가 물리적으로 독립된 메모리를 사용한다.
・ MPS(Metal Performance Shaders)
a. Apple이 개발한 기술로, 애플의 그래픽 API인 Metal을 기반으로 한다. Mac 기기에서만 작동한다.
b. PyTorch 등에 백엔드로 통합되어 있어, Mac 환경에서도 PyTorch 코드를 이용해 애플 실리콘의 GPU를 이용할 수 있다.
c. CUDA에 비해 커뮤니티 자료가 적고 최적화가 까다로울 수 있다.
d. CPU와 GPU가 메모리를 공유하는 통합 메모리 구조를 가진다.
e. 이로 인해 대용량 언어 모델(LLM)을 로컬에서 구동할 때, 그래픽 메모리(VRAM) 부족 현상 없이 시스템 메모리를 공유하여 효율적으로 활용할 수 있다.
4. GPU 사용 테스트
- (1) 실시간 GPU, CPU 사용량 확인
・ asitop 설치
pip install asitop
・ asitop 실행
sudo asitop
a. Password:에 컴퓨터 로그인 비밀번호를 입력한다.
・ 실행 화면
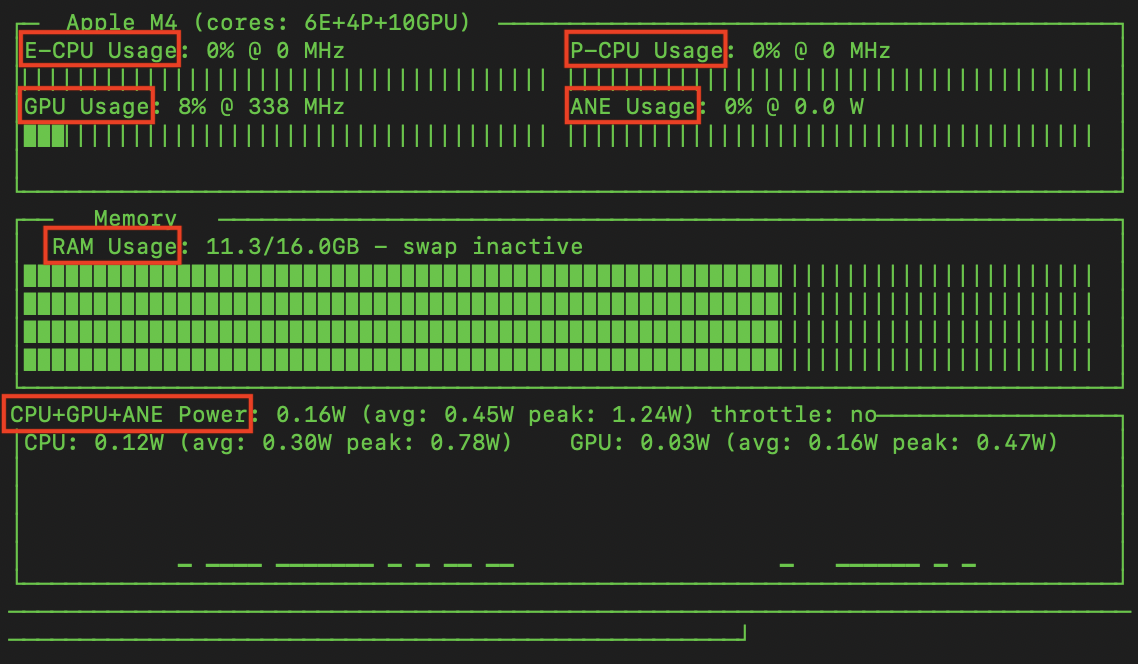
a. E-CPU (Efficiency CPU cores) : 효율성을 위해 설계된 CPU 코어. 가벼운 작업
➜ 에너지 소비가 낮으면서도 일상적인 작업을 처리하는 데 사용된다.
➜ 일반적인 애플리케이션 및 백그라운드 작업에서 주로 사용된다.
b. P-CPU (Performance CPU cores) : 성능을 위해 설계된 CPU 코어. 무거운 작업
➜ 높은 계산 능력이 필요한 작업(ex. 게임, 편집 등)을 처리하는 데 주로 사용된다.
c. GPU Usage : 실시간 GPU 사용률
➜ 그래픽 처리에 사용되는 GPU의 활동 수준을 보여준다.
➜ 비디오 렌더링, 게임 플레이, 그래픽 디자인 작업 등 그래픽 집약적 작업을 모니터링할 때 유용하다.
d. ANE Usage (Apple Neural Engine Usage) : Apple Neural Engine 사용률
➜ 머신 러닝 작업이 얼마나 활발하게 실행되고 있는지 나타낸다.
e. CPU + GPU + ANE Power : CPU + GPU + ANE 전력 사용률
- (2) GPU 사용 확인
・ 아래 코드를 이용해 실제로 GPU를 사용하는지 확인한다.
import torch
import math
dtype = torch.float
device = torch.device("mps")

# Create random input and output data
x = torch.linspace(-math.pi, math.pi, 2000, device=device, dtype=dtype)
y = torch.sin(x)

# Randomly initialize weights
a = torch.randn((), device=device, dtype=dtype)
b = torch.randn((), device=device, dtype=dtype)
c = torch.randn((), device=device, dtype=dtype)
d = torch.randn((), device=device, dtype=dtype)

learning_rate = 1e-6
for t in range(5000):
    # Forward pass: compute predicted y
    y_pred = a + b * x + c * x ** 2 + d * x ** 3

    # Compute and print loss
    loss = (y_pred - y).pow(2).sum().item()
    if t % 100 == 99:
        print(t, loss)

# Backprop to compute gradients of a, b, c, d with respect to loss
    grad_y_pred = 2.0 * (y_pred - y)
    grad_a = grad_y_pred.sum()
    grad_b = (grad_y_pred * x).sum()
    grad_c = (grad_y_pred * x ** 2).sum()
    grad_d = (grad_y_pred * x ** 3).sum()

    # Update weights using gradient descent
    a -= learning_rate * grad_a
    b -= learning_rate * grad_b
    c -= learning_rate * grad_c
    d -= learning_rate * grad_d


print(f'Result: y = {a.item()} + {b.item()} x + {c.item()} x^2 + {d.item()} x^3')
'Bioinformatics > Python' 카테고리의 다른 글
| [Python] 가상환경 만들기 for Mac (0) | 2026.05.16 |
|---|---|
| [Python] VS Code에서 Python 사용하기 for Mac (0) | 2026.05.16 |
| [Python] Anaconda 설치하기 for Mac (0) | 2026.05.16 |


댓글 영역